用 SSH 给自己开一条代理通道:把本地代理反向借给远程服务器
摘要远程服务器上 pip install、git clone、huggingface-cli download 全都卡住,装个代理客户端却发现节点全部超时——而本地电脑上的代理明明好得很。本文从这次真实排查讲起,用 SSH 反向端口转发(ssh -R) 把本地代理”借”给服务器,让服务器的出口 IP 变成你本地的出口 IP。文中的 IP、端口、耗时数据都来自一次真实排查,可以直接对照复现。 一、从一个真实的尴尬问题说起场景很典型: 你有一台本地电脑,上面跑着代理软件(Clash / mihomo / sing-box 之类),本地 HTTP 代理端口 7897,上网一切正常。 你还有一台远程服务器(云主机、公司跳板机、超算容器、实验室工作站)。你在上面跑 pip install、git clone、huggingface-cli download,全都卡住。 于是你在服务器上也装了个代理客户端,配了订阅,结果节点全部超时。 排查时的输出大概长这样: 123456789$ curl -s -m 12 -x http://127.0.0.1:7890 htt...
Tailscale 与 Clash 共存排查 SOP
同一台 Mac 同时运行 Tailscale 和 Clash 后,启智平台打不开了。恢复启智访问后,另一个问题又出现了:Tailscale 设备能 ping 通,浏览器却打不开它的服务首页。 两次故障发生在不同环节。启智请求最初卡在 DNS;Tailscale 服务则是直接访问返回 HTTP 200,经过本地 Clash 代理返回 502。最后的配置是:Tailscale 保留设备互联,关闭 DNS 和接受子网路由;Clash 继续按规则分流,同时在 TUN 和系统代理两处绕过 Tailscale 目标。 下面先复盘证据,再给出可以直接复用的排查 SOP。设备地址统一替换为示例 100.101.102.103,代理端口以本次环境的 7897 为例。 1. 先明确要保留的网络行为这次需求很具体:通过 Tailscale IP 访问一台设备上的服务,其余日常访问继续由 Clash 按现有规则处理。既不需要用设备名访问,也不需要借助远端设备访问它背后的局域网。 功能 负责什么 本次选择 Tailscale 设备互联 通过虚拟 IP 连接已加入 tailnet 的设备 保...
Tailscale 能做什么?从 WireGuard、NAT 穿透到中继的运行原理
家里的电脑、云服务器和随身携带的笔记本,通常位于不同网络。想从外面连接家中电脑,往往要处理公网 IP、端口映射、动态 DNS 和防火墙;如果遇上运营商级 NAT,连端口映射都未必可行。 Tailscale 的作用,就是让这些设备加入一张受身份和访问策略管理的虚拟内网。设备可以通过相对稳定的虚拟 IP 或设备名互相访问,底层则尽量建立点对点加密连接,无法直连时使用中继。 它主要解决“自己的设备如何互联”,默认不会把所有公网访问都改成从远端出站。 理解这一点,也就容易区分 Tailscale、普通代理和出口节点的用途。 1. Tailscale 能解决哪些问题假设有四台设备: 1234MacBook:随身使用,在家、学校和咖啡店之间切换Linux 服务器:运行开发环境和模型服务家用电脑:保存文件,偶尔需要远程桌面手机:在移动网络下访问内部服务 它们加入同一个 Tailscale 网络后,就可以在策略允许的范围内,通过虚拟网络通信。这张网络称为 tailnet。 场景 具体用法 远程开发 SSH 连接服务器,使用 VS Code Remote SSH 访问开发服务...
开启 Tailscale 后,Clash 出口为什么变成中国?一次 IPv6 绕过代理的排查与修复
开启 Tailscale 后,Clash 明明选中了海外节点,查 IP 网站却显示中国。第一反应是:两个软件都创建虚拟网卡,是不是互相冲突了? 这次排查发现,海外代理节点仍然正常,IPv4 经过 Clash,公网 IPv6 却绕过了 Clash,直接从本地宽带出站。支持 IPv6 的网站可能显示国内地址,仅支持 IPv4 的网站则仍然显示海外地址。 修复方法是为 Clash TUN 补上 IPv6 地址,让 Mihomo 自动建立 IPv6 接管路由,同时排除 Tailscale 的内网网段。修复后,两者可以继续同时使用。 1. 现象与运行环境本次环境是 macOS,使用 Clash Verge Rev,内核为 Mihomo v1.19.32,Tailscale 版本为 1.102.4。 当时的设置如下: 项目 状态 Clash TUN 模式 开启 Clash 系统代理 关闭 Clash 分流模式 Rule Clash 顶层 ipv6 true Clash TUN auto-route true Tailscale 已连接 Tailscal...
Clash 的运行原理(2):实例和各种代理协议
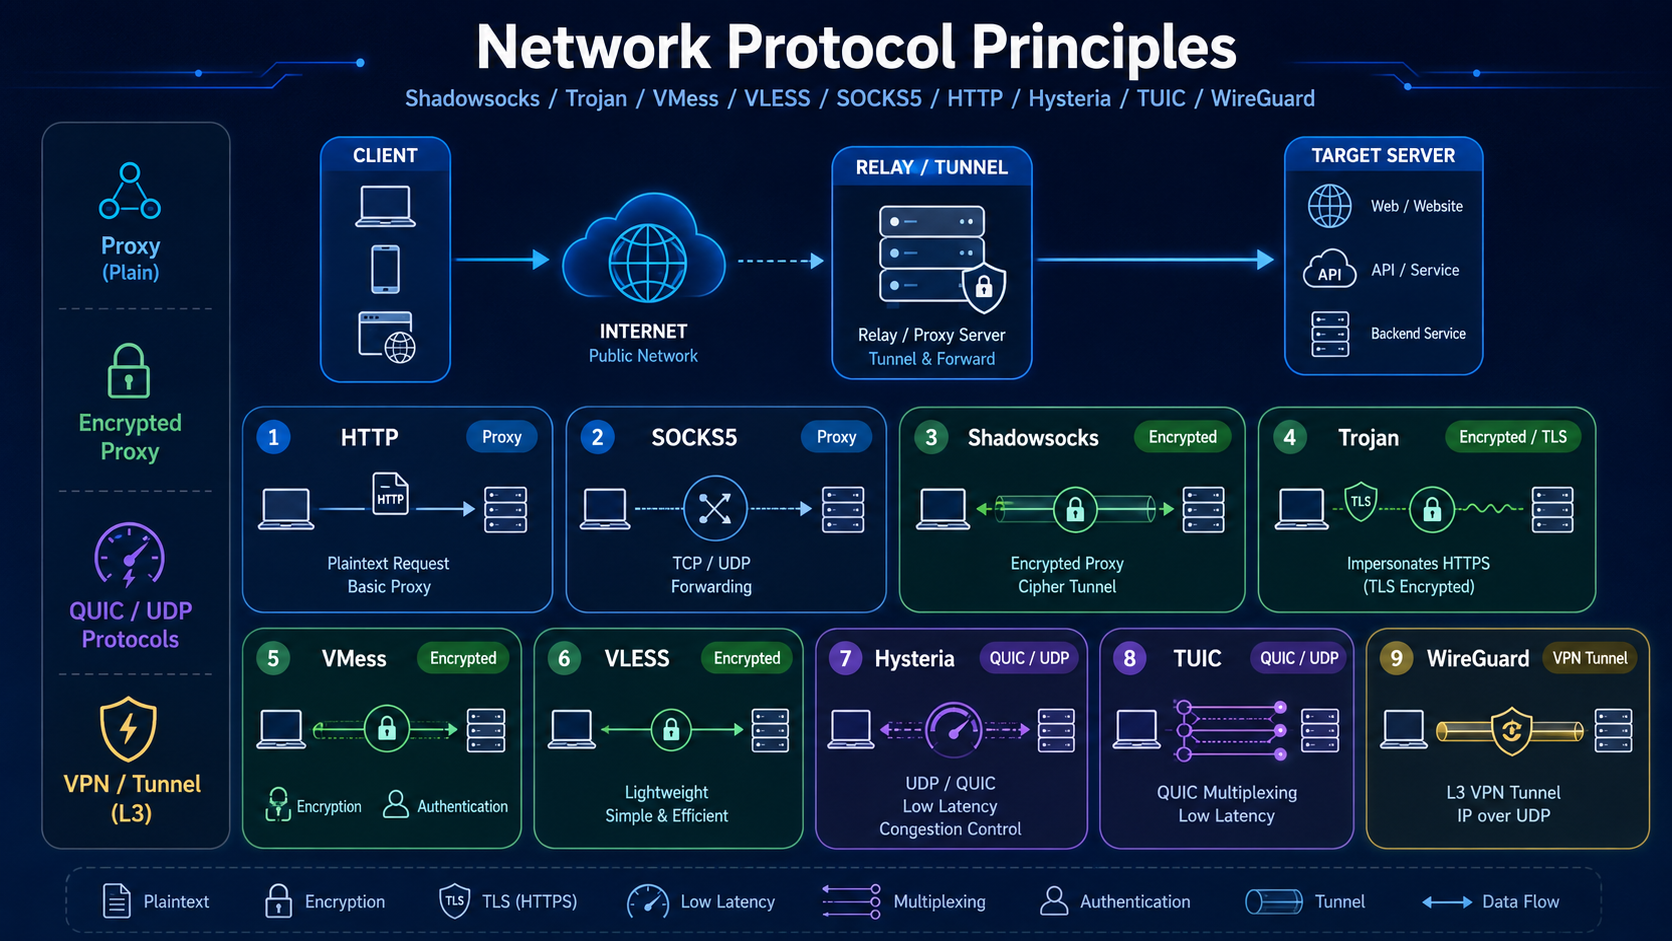
1. 一次 HTTPS 请求在 Clash 中的完整生命周期以访问 https://www.google.com 为例。 第一步:应用发起 DNS 查询浏览器要访问: 1www.google.com 它先请求 DNS 解析。 第二步:Clash DNS 返回 fake-ip如果开启 fake-ip,Clash 可能返回: 1www.google.com → 198.18.0.23 同时 Clash 记录映射: 1198.18.0.23 → www.google.com 第三步:浏览器连接 fake-ip浏览器以为 198.18.0.23 就是目标地址,于是建立 TCP 连接。 第四步:连接进入 Clash由于系统代理、TUN 或透明代理规则,这条连接进入 Clash。Clash 查映射表,知道: 1198.18.0.23 实际对应 www.google.com 第五步:规则匹配Clash 检查规则: 1- DOMAIN-SUFFIX,google.com,PROXY 命中后,决定走 PROXY 策略组。 第六步:策略组选择节点假设当前 PROXY 选择的是 troja...
Clash 的运行原理(1):从虚拟网卡到 DNS 分流
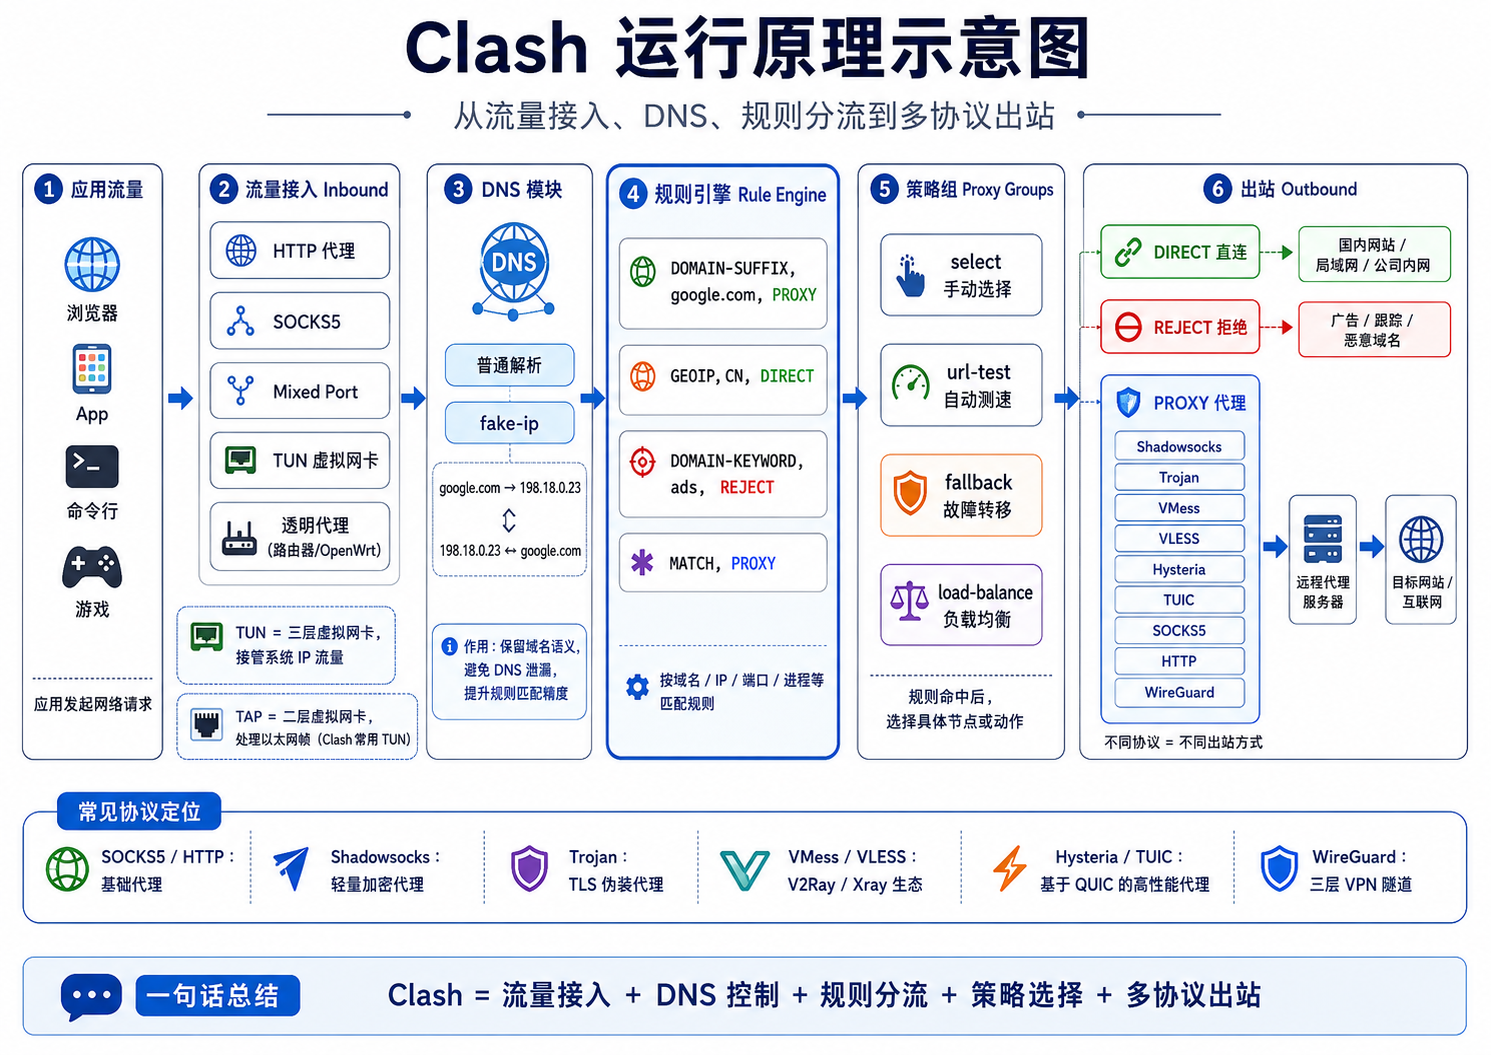
Clash 的运行原理:从虚拟网卡到 DNS 分流 摘要Clash 是一个运行在本机或网关上的规则化代理转发引擎。它把应用程序或系统网络栈产生的流量接入本地,再通过 DNS 模块、规则引擎和策略组判断流量应该直连、拒绝,还是通过某个远程代理节点转发出去。 Clash 可以理解为以下几个模块的组合: 123456流量入口 Inbound+ DNS 解析与 fake-ip 映射+ 规则匹配引擎+ 策略组选择器+ 多协议出站 Outbound+ 远程代理服务器或直连出口 它和传统 VPN 的主要区别在于:传统 VPN 通常把整台设备的 IP 流量放进一个加密隧道,而 Clash 更强调按规则分流。同一台设备上,国内网站可以直连,海外网站可以走代理,广告域名可以拒绝,公司内网可以走 WireGuard,游戏 UDP 可以走 Hysteria 或 TUIC。Clash 的价值是把复杂网络流量按域名、IP、端口、进程、地理位置和协议特征进行精细路由。 1. 先区分几个概念:VPN、代理、Clash日常语境里,很多人会把 Clash、Trojan、Shadowsocks、VLESS 统...
ONNX
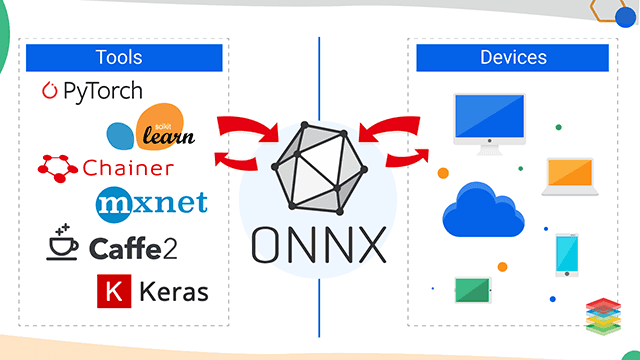
ONNX 可以理解为机器学习模型的中间表示格式:训练时可以用 PyTorch、TensorFlow、scikit-learn 等框架,部署时把模型导出成 .onnx,再交给 ONNX Runtime、TensorRT、OpenVINO、CoreML、DirectML 等后端执行。 1. ONNX 是什么ONNX,全称 Open Neural Network Exchange,是一个开放的 AI 模型格式。它定义了三类核心内容:计算图模型、内置算子、标准数据类型;官方也明确说当前重点主要是 inference/scoring,而不是完整训练框架替代品。(GitHub) 一句话概括: ONNX 是模型交换格式和推理部署 IR。 典型链路是: 1234567PyTorch / TensorFlow / sklearn ↓ export / convert model.onnx ↓ runtime / compilerONNX Runtime / TensorRT / OpenVINO / CoreML / TVM / custom ...
融合算子
融合算子本质上是:把计算图中多个连续的小算子合并成一个更大的算子或一个 GPU kernel,让它们一次性执行,减少中间结果写回显存、减少 kernel launch、减少 layout 转换,从而提高推理性能。 在 TensorRT、TVM、XLA、TorchInductor、ONNX Runtime、TensorRT-LLM 里,算子融合都是核心优化。 1. 为什么要融合算子GPU 推理不只是“算力瓶颈”,很多时候是: 1读显存 → 算一点 → 写显存 → 再读显存 → 再算一点 → 再写显存 例如: 1Conv → BatchNorm → ReLU 如果不融合,大概是: 12345678910111213kernel 1: Conv input 从显存读入 weight 从显存读入 conv 输出写回显存kernel 2: BatchNorm conv 输出再从显存读入 BN 参数读入 BN 输出写回显存kernel 3: ReLU BN 输出再从显存读入 ReLU 输出写回显存 问题有两个: 第一,中间 tensor 反复读写显存。第二,每个 ke...
GEMM
GEMM 是 General Matrix Multiply,中文通常叫通用矩阵乘法。它是深度学习里最核心的计算形式之一。 它的标准形式是: C = \alpha A B + \beta C 其中: 1234A: m × k 矩阵B: k × n 矩阵C: m × n 矩阵α, β: 标量 如果忽略 $\alpha$、$\beta$,最常见的理解就是: 1C = A @ B 也就是矩阵乘矩阵。 1. GEMM 为什么重要神经网络里的很多算子,最后都可以转成 GEMM。 例如全连接层 / Linear 层: 1y = x @ W + b 如果: 12x: batch × hiddenW: hidden × output 那么: 1y: batch × output 这本质就是 GEMM,加上一个 bias。 Transformer 里的 Q、K、V 投影也是 GEMM: 123Q = X @ WqK = X @ WkV = X @ Wv MLP 也是 GEMM: 12H = GELU(X @ W1 + b1)Y = H @ W2 + b2 Att...
正则化
正则化(regularization):在优化训练误差之外,额外加入一种约束或偏好,使模型不要为了拟合训练集而学出过于复杂、过于极端、过于脆弱的解。 最常见的形式是: $$\min_\theta \ \mathcal{L}_{train}(\theta) + \lambda \Omega(\theta)$$ 其中: $\mathcal{L}_{train}(\theta)$ 是训练损失; $\Omega(\theta)$ 是正则项,用来惩罚某种“不希望出现的模型性质”; $\lambda$ 控制正则化强度; $\theta$ 是模型参数。 例如 L2 正则化: $$\min_\theta \ \mathcal{L}_{train}(\theta) + \lambda |\theta|_2^2$$ 模型不仅要拟合训练数据,还要尽量让参数不要太大。 1. 从第一性原理看:机器学习到底在做什么?机器学习的目标是学到一个能够泛化到未知样本的函数。 理想目标是最小化真实风险: $$R(f)=\mathbb{E}{(x,y)\sim P{data}}[\ell(f(x),y)...